Wo das Handbuch endet, fange ich an.

Von der Platine bis zum Cap Table.

Seit 2006 baue ich Systeme. Head of Engineering bei wywy bis zum Verkauf an TVSquared. Seit 2019 Mitgründer und CTO von SMAHO, einer Connected-Home-Plattform.

Wo es meistens anfängt

Ein Deal wartet auf eine technische Antwort

Investoren, Angels, Käufer, CTOs vor einem Deal

Due Diligence

Architektur-Review

Ausgangslage

Geprüft haben das Design bisher nur die, die es gebaut haben, und sie prüfen, was sie bauen wollten.

Ergebnis

Befunde nach Risiko sortiert, jeder mit seinem Fix.

Leistung

Ich gehe dein System mit deinem Team durch und halte fest, was du ändern solltest und in welcher Reihenfolge. Das ist kein Pentest und keine Zertifizierung; brauchst du eines davon, sagt dir das Review, welches.

Rahmen
  • Software · Security und Identity · IoT und Geräteflotte · Infrastruktur
  • Drei bis fünf Arbeitstage, das Ergebnis innerhalb von zwei Wochen.
  • Festpreis, vereinbart in der schriftlichen Leistungsbeschreibung.
Eine Befundseite als Muster. Zu jedem Risiko gehören Fix und Aufwand.

So läuft es ab

  1. 1Ein 30-minütiges Gespräch darüber, warum jetzt und welcher Schwerpunkt passt.
  2. 2Innerhalb eines Tages bekommst du eine schriftliche Leistungsbeschreibung mit Liefertermin.
  3. 3Dein Tech-Lead zeigt mir das System so, wie es wirklich läuft.
  4. 4Ich lese Code, Konfiguration und Incident-Notizen und spreche mit deinen Entwicklern.
  5. 5Wir gehen die Befunde mit deinem Team durch, und du legst die Reihenfolge der Fixes fest.
  6. 6Zu einem vereinbarten Termin prüfen wir gemeinsam, welche Fixes erledigt sind.

Was ich von dir brauche

  • Lesezugriff auf Code, Cloud-Konsole und Monitoring genügt.
  • Deine Diagramme und Notizen zu Incidents.
  • Zwei Stunden mit deinem Tech-Lead.
  • Für ein Geräte-Review ein Exemplar auf meinem Tisch.
Dazu anfragen
Due Diligence

Technische Due Diligence

Ausgangslage

Ein Risiko, das nach dem Signing auftaucht, bezahlst du. Taucht es vorher auf, kommt es in die Konditionen.

Ergebnis

Ein Urteil auf einer Seite, jedes Risiko bewertet.

Leistung

Ein unabhängiger Blick auf die Technik, bevor Geld an ihr hängt. Ich arbeite für dich und sage das dem Zielunternehmen auch so. Von einer Firma, die ich prüfe, nehme ich zwölf Monate lang keinen Auftrag an. Eine Firma, für die ich gearbeitet habe, in die ich investiert habe oder die mit SMAHO konkurriert, prüfe ich nicht.

Rahmen
  • Red-Flag-Review: 2 Arbeitstage · Standard: 4–6 · Sell-Side-Readiness: 5–8
  • Hat das Zielunternehmen Geräte, prüfe ich auch Firmware, Over-the-Air-Updates, Gerätezertifikate, Provisionierung in der Fertigung und Flottenmanagement.
  • Festpreis, vereinbart in der schriftlichen Leistungsbeschreibung.
Eine Urteilsseite als Muster. Jedes Risiko trägt seine Einstufung und seinen Beleg.

So läuft es ab

  1. 1Ein 30-minütiges Gespräch über den Deal, die Frist und deine Fragen.
  2. 2Innerhalb eines Tages bekommst du eine schriftliche Leistungsbeschreibung mit Liefertermin.
  3. 3Ich lese den Code und verfolge, wie er in Produktion kommt.
  4. 4Ich spreche mit dem CTO und den Entwicklern, die das System bauen und betreiben.
  5. 5Im Standard-Umfang hörst du die ersten Befunde schon zur Halbzeit.
  6. 6Wir gehen die Befunde gemeinsam durch, danach bekommst du das schriftliche Urteil.

Was ich von dir brauche

  • Die Zustimmung des Zielunternehmens zur Prüfung.
  • Lesezugriff auf Code und Cloud-Konsole, eingerichtet vom Zielunternehmen.
  • Eine Stunde mit jeder Person, die in der Leistungsbeschreibung steht.
  • Kommt der Zugang später, verschiebt sich der Liefertermin um ebenso viele Tage.
Dazu anfragen

Eine Idee, Geld und niemand für die Technik

Gründer vor der ersten Zeile Code

Produkt

MVP-Scoping

Ausgangslage

Jedes Agenturangebot sieht vollständig aus. Was fehlt, steht später auf der Rechnung.

Ergebnis

Ein Briefing auf einer Seite, als Basis für Angebote.

Leistung

Bevor du Geld für Code ausgibst. Zwischen den Terminen arbeitest du; ich sorge dafür, dass es die richtige Arbeit ist. Go-to-Market, Fundraising und Verträge bleiben außen vor.

Rahmen
  • Zwei bis vier Termine in einem Monat.
  • Festpreis, vereinbart in der schriftlichen Leistungsbeschreibung.
Ein Gründer-Briefing als Muster. Du verschickst es, nicht ich.

So läuft es ab

  1. 1Wir beginnen mit dem Problem deines Kunden, nicht mit deiner App.
  2. 2Bis zum nächsten Termin sprichst du mit fünf möglichen Kunden.
  3. 3Den ersten Schritt richten wir danach aus, wie viel Zeit und Geld du einsetzen willst, um die Idee zu testen.
  4. 4Für jeden Baustein entscheiden wir: bauen, kaufen oder einstellen.
  5. 5Die Angebote lesen wir gemeinsam.
  6. 6Bei deinen ersten Gesprächen mit Entwicklern oder Agenturen bin ich dabei.

Was ich von dir brauche

  • Was schon da ist: Deck, Notizen, Skizzen, vorhandene Angebote.
  • Deine Budgetobergrenze und das Datum, auf das es ankommt.
  • Wer außer dir mitentscheidet.
Dazu anfragen

Ein Projekt stockt, oder niemand findet den Fehler

VPs Engineering, Plattform-Leads, Gerätehersteller

Hands-on

Hands-on-Mandat

Ausgangslage

Dein Team hält alles andere am Laufen, also bekommt das schwierigste Projekt nur die Zeit, die übrig bleibt.

Ergebnis

Live und übergeben, oder schriftlich begründet gestoppt.

Leistung

Ich arbeite in deinem Team und übernehme ein Projekt, egal wo im Plattform- und Software-Stack, bis es ausgeliefert ist. Mein Schwerpunkt sind API, Backend, Plattform und Infrastruktur.

Rahmen
  • Ab drei Monaten · Zwei bis drei Tage pro Woche
  • Abgerechnet nach Tagessatz.
Eine Notiz zu Tag 10 als Muster. Am zehnten Tag weißt du, was das Projekt blockiert.

So läuft es ab

  1. 1Vor dem Start halten wir das eine Ergebnis fest, auf das es ankommt.
  2. 2Wir legen auch fest, woran wir erkennen, dass wir abbrechen sollten.
  3. 3An Tag 10 schreibe ich dir, was das Projekt blockiert und wie ich vorgehe.
  4. 4Ich messe zuerst und ändere dann in kleinen Schritten, die sich zurücknehmen lassen.
  5. 5Jede Woche bekommst du einen kurzen schriftlichen Stand.
  6. 6Bevor ich gehe, betreibt dein Entwickler das System, während ich zuschaue.

Was ich von dir brauche

  • Zugänge am ersten Tag und eine Person, die an dem Tag erreichbar ist.
  • Ein Sponsor, der Blocker aus dem Weg räumt.
  • Ein Entwickler, der das Ergebnis nach mir verantwortet.
Dazu anfragen
Hands-on

Root-Cause-Analyse

Ausgangslage

Der Fehler zeigt sich nie in Staging, und jede Vermutung hat bisher ein Release gekostet.

Ergebnis

Wie der Fehler entsteht, und ein Test, der den Fix prüft.

Leistung

Den Fehler, den Staging nie zeigt, suche ich dort, wo er auftritt: in Produktion, zunächst lesend und immer mit einem deiner Entwickler. An Arbeitstagen antworte ich innerhalb weniger Stunden, spätestens am nächsten Arbeitstag. Eine Rufbereitschaft gibt es nicht.

Rahmen
  • Zwei bis vier Wochen · Zwei bis drei Tage pro Woche
  • Abgerechnet nach Tagessatz.
Ein Hypothesen-Log als Muster. Sackgassen bleiben drin, damit niemand sie zweimal testet.

So läuft es ab

  1. 1Ein erstes Gespräch darüber, was schiefgeht, seit wann und wo nicht.
  2. 2Dein Entwickler führt mich den Weg entlang, den der Fehler nimmt.
  3. 3Ich sammle die fehlenden Daten, bevor ich Ursachen vermute.
  4. 4Das Hypothesen-Log bekommst du jeden Tag aktuell.
  5. 5Der kleinste Fall, der den Fehler zeigt, wird zum Test für den Fix.
  6. 6Am Ende bekommst du einen Bericht über die Ursache und was als Nächstes zu ändern ist.
  7. 7Findet sich die Ursache nicht in der vereinbarten Zeit, bekommst du eine schriftliche Begründung für den Abbruch.

Was ich von dir brauche

  • Zugänge, eingerichtet vor dem ersten Tag.
  • Ein Entwickler an meiner Seite.
  • Die Zeitpunkte der letzten Vorfälle, wenn du sie hast.
Dazu anfragen

KI-Agenten sind im Einsatz, die Ergebnisse durchwachsen

Engineering-Leads

KI-Agenten

Agentic Kickstart

Ausgangslage

In deinem Team arbeitet jeder anders mit KI-Agenten. Welche Entscheidungen ein Agent allein treffen darf, steht nirgends.

Ergebnis

KI-Agenten mit Regeln, Freigaben und Protokoll.

Leistung

Die meisten Teams haben inzwischen eine Anweisungsdatei für KI-Agenten. Der Kickstart geht weiter: wer entscheidet, was allein läuft, was ein Mensch abzeichnet und wie aus Fehlern Regeln werden. In der Regel remote; den Workshop vor Ort, wenn du willst.

Rahmen
  • Ein Workshop, danach wöchentliche Check-ins, die nach und nach auslaufen.
  • Festpreis, vereinbart in der schriftlichen Leistungsbeschreibung.
Ein Regelbuch als Muster. Jede Regel darin geht auf einen Vorfall in meiner eigenen Arbeit zurück.

So läuft es ab

  1. 1Ich lese die Repositories deines Teams und verfolge, wie die Arbeit durchs Team läuft.
  2. 2Du bekommst eine kurze schriftliche Bestandsaufnahme und den Plan für den Workshop.
  3. 3Im Workshop schreiben wir auf, wer entscheidet und was KI-Agenten allein entscheiden dürfen.
  4. 4Mit deinem Team richten wir gemeinsame Regeln, wiederverwendbare Skills, einen koordinierenden KI-Agenten und Freigabestufen ein.
  5. 5Jeder Entwickler erledigt eine echte Aufgabe nach den neuen Regeln.
  6. 6Die wöchentlichen Check-ins laufen aus, während dein Team aus wiederholten Fehlern Regeln macht.

Was ich von dir brauche

  • Lesezugriff auf die wichtigsten Repositories deines Teams.
  • Die Tools für KI-Agenten, die dein Team nutzt, und die Regeln, die es schon hat.
  • Welche Daten das Unternehmen verlassen dürfen.
Dazu anfragen

Kein CTO oder kein Gegenüber für die Entscheidung

CEOs, Gründer, CTOs, die allein entscheiden

Führung

Interim-CTO

Ausgangslage

Einen festen CTO zu finden dauert Monate. Bis dahin wartet jede technische Entscheidung auf dich, oder der Lauteste trifft sie.

Ergebnis

Für jede Entscheidung ein Verantwortlicher, die Übergabe zum vereinbarten Termin.

Leistung

Ich leite dein Engineering-Team an zwei bis drei Tagen pro Woche, remote. Das Ende ist vereinbart, bevor ich beginne. Welche Entscheidungen bei mir liegen, halten wir schriftlich fest; für deine lege ich die Konsequenzen vorher offen.

Rahmen
  • Drei bis neun Monate · Zwei bis drei Tage pro Woche
  • Abgerechnet nach Tagessatz.
Ein Plan zu Tag 30 als Muster. Jeder Punkt hat einen Verantwortlichen und ein Datum.

So läuft es ab

  1. 1Bevor ich anfange, halten wir schriftlich fest, welche Entscheidungen ich treffe und welche bei dir bleiben.
  2. 2Du sagst deinem Team, welche Rolle ich habe und wann ich gehe.
  3. 3In den ersten zwei Wochen spreche ich mit deinen Entwicklern und liefere selbst eine kleine Änderung aus.
  4. 4An Tag 10 schreibe ich dir kurz auf, was ich sehe.
  5. 5Bis Tag 30 bekommst du eine Diagnose und einen Plan.
  6. 6Zeigt der Plan zu Tag 30, dass du mich nicht mehr brauchst, kannst du die Zusammenarbeit dort beenden.
  7. 7Sonst leite ich das Team und schreibe dir jede Woche ein kurzes Update.
  8. 8Deine nächste technische Leitung arbeitet zuerst an meiner Seite und übernimmt dann zum vereinbarten Termin.

Was ich von dir brauche

  • Zugänge am ersten Tag und eine Person, die an dem Tag erreichbar ist.
  • Ein Organigramm, das letzte Board-Deck, das Budget und die Incident-Historie.
  • Eine Stunde pro Woche mit dir.
Dazu anfragen
Führung

CTO-Sparring

Ausgangslage

Wer dir widersprechen könnte, berichtet an dich. So schaut auf eine unumkehrbare Entscheidung niemand ein zweites Mal.

Ergebnis

Entscheidungen schriftlich: Grund, Verantwortlicher, Wiedervorlage.

Leistung

Eine zweite Meinung von jemandem, der solche Entscheidungen selbst getroffen hat. Ich frage, bis die Entscheidung klar ist, dann empfehle ich. Du entscheidest.

Rahmen
  • Einzelne Tage oder ein monatlicher Retainer für mindestens drei Monate.
  • Fragen per Mail dazwischen beantworte ich innerhalb eines Arbeitstags.
  • Abgerechnet nach Tagessatz, oder monatlich in halben Tagen.
Ein Entscheidungsprotokoll als Muster. Die echten bleiben in deinen Tools, nicht in meinen.

So läuft es ab

  1. 1Zwei Tage vor dem Termin schickst du mir eine Seite zur Entscheidung.
  2. 2Ich antworte mit den Fragen, die ich vorher geklärt haben muss.
  3. 3Zuerst prüfen wir, ob sich die Entscheidung rückgängig machen lässt.
  4. 4Dann gehen wir die Optionen durch und was jede kostet.
  5. 5Ich gebe meine Empfehlung, und du entscheidest.

Was ich von dir brauche

  • Die eine Seite zur Vorbereitung, pünktlich.
  • Lesezugriff auf deine Architekturnotizen.
  • Ehrlichkeit darüber, was schiefläuft.
Dazu anfragen

Referenzen, die ich nennen darf

Hier steht, was ich nennen darf.

  • Ein Firmenverkauf, von der Due Diligence bis zur Integration

    an TVSquared verkauft · stabile Auslieferung während der Integration

    Ich habe wywy auf den Verkauf und auf die technische Due Diligence des Käufers vorbereitet. Danach habe ich unsere Infrastruktur in die Plattform des Käufers überführt und zwei Engineering-Kulturen zusammengebracht. Die Prüfung entscheidet über den Deal, das Jahr danach darüber, ob er sich gelohnt hat.

  • Die Engineering-Organisation aufgebaut und mit der des Käufers zusammengeführt

    15+ Engineers in München und Edinburgh · Strategie und Budget mit CEO und COO geplant

    Ich habe das Plattformteam aufgebaut und später zusätzlich das Produktteam geführt. Nach dem Verkauf war ich regelmäßig zu Management-Meetings in Edinburgh und habe daran gearbeitet, aus dem wywy-Team und TVSquared ein Team über beide Standorte zu machen. Aufgebaut ist eine Organisation erst, wenn sie in den Wochen ohne mich genauso läuft.

  • Strategie und Roadmap durch eine zerrissene Lieferkette

    Lieferzeiten für Bauteile von unter 10 Tagen auf über 50 Wochen · Fertigung außerhalb des Embargos verlagert

    Als CTO plane ich App, Plattform, Infrastruktur und Hardware als eine Roadmap, die Beschaffung der Bauteile eingeschlossen. Diese Roadmap vertrete ich selbst vor Gesellschaftern, Investoren, Kunden, Lieferanten und Integratoren. Als ein Containerschiff den Suezkanal blockierte, stiegen unsere Lieferzeiten von Tagen auf fast ein Jahr, und später schnitt ein US-Embargo auf CPUs unseren Hersteller in China von den Teilen ab. Wir haben früh auf Vorrat gekauft und die Fertigung zu einem Hersteller außerhalb des Embargos verlagert. Bei einem Hardwareprodukt bestimmt die Lieferkette die Roadmap so oft wie der Kunde.

  • Ein Angel, der im Raum bleibt

    Product Discovery · Interim-CTO · die ersten Engineers eingestellt · auf Product Hunt gestartet, Oktober 2026

    Von Anfang an dabei: erst Product Discovery, dann die Arbeit als Interim-CTO, bei der ich mit angepackt habe, wo die Entwicklung technische Führung brauchte. Später habe ich die ersten Engineers ausgewählt und eingestellt, blieb ihnen auf Augenhöhe ansprechbar und habe die Rolle an sie übergeben. Gesellschafter seit dem ersten Tag.

  • Routinearbeit an Agenten übergeben, im ganzen Team

    App-Releases durch Agenten · Steuerung in natürlicher Sprache live in der App

    Agenten entwerfen Routinearbeit und Antworten für den Support, und zeitgesteuerte Agenten schreiben jede Woche einen Bericht über die Organisation. Was sich rückgängig machen lässt, erledigen sie selbst. Alles andere geht als schriftliche Entscheidung an einen Menschen, und genau dort würde ich die Grenze in jedem Unternehmen ziehen.

  • Komplett mit KI-Agenten gebaut

    Quest-App · Website · Operations-Dashboard · Städte-Scoring-Modell · Content-Pipeline mit 30 Workflows

    Ein Stadtabenteuer in Textform, gespielt auf echten Straßen. Alles von einer Person: Produkt, Plattform, App. Die Content-Pipeline läuft auf LangGraph, und nichts geht live, bevor ein Mensch es gelesen hat. Hier baue ich so, wie ich es anderen empfehle.

  • Eigene Hardware, von der Platine des Partners bis in die Fertigung

    Tausende Geräte im Feld · aus der Ferne aktualisiert und diagnostiziert

    Wir haben die Platine eines Designpartners bis in die Fertigung gebracht und die App in beide App-Stores. Firmware und Provisionierung blieben im Haus, die Gerätesicherheit ebenso. Wer ein Gerät verkauft, sollte selbst in der Hand haben, was darauf läuft.

  • Kein Schlüsselpersonenrisiko in der Infrastruktur

    allein aus Git neu aufbaubar · jede Änderung geprüft, bevor sie live geht

    Nichts daran hängt davon ab, was ich im Kopf habe. Danach sollte ein Investor jeden CTO fragen, und die Antwort sollte langweilig sein.

  • Login und Berechtigungen im laufenden Betrieb ersetzt

    Tausende Geräte und Nutzer · ohne Ausfall

    Das neue System lief parallel zum selbst gebauten Altsystem, bis beide dieselben Antworten gaben, und übernahm dann. Der Parallelbetrieb kostet Zeit, dafür bemerkt kein Kunde den Wechsel.

  • Zehn- bis zwanzigmal mehr Arbeit pro Server

    Obergrenze für Live-Feeds pro Server aufgehoben

    Die Engine erkannte TV-Werbespots so, wie Shazam Songs erkennt. Ich habe das Team geführt, das sie in Go neu geschrieben hat. Gegenüber dem Python-Original lag der Gewinn beim Zehn- bis Zwanzigfachen, je nach Transpondergröße und Algorithmus. Eine Neuentwicklung lohnt sich nur, wenn sie eine Obergrenze beseitigt.

  • Vier Rechenzentren als eines betrieben, ohne Wartungsfenster

    München · New York · Oakland · Tel Aviv

    Eine eigene Private Cloud. Neue Server kamen bei Bedarf dazu und richteten sich anhand ihres Hardwareprofils selbst ein. Kapazität, die sich selbst einrichtet, muss niemand einplanen.

  • Hunderte Live-TV-Feeds auf einem Bruchteil der Hardware

    mehrere Racks → wenige Höheneinheiten

    Weil F&E im Haus blieb, ersetzten eigene Server die proprietären Receiver, und die Kanalkapazität konnte wachsen. Wer den schwierigen Teil selbst beherrscht, entscheidet auch selbst über das Wachstum.

  • Ein Alarm hieß: echter Fehler

    Rufbereitschaft für eine Plattform ohne Wartungsfenster

    Fällt ein Satellitensignal wegen schlechten Wetters aus, kommt es von selbst zurück. Das Monitoring lernte, das von einem echten Fehler zu unterscheiden, und alarmierte dafür niemanden mehr. Ein Alarm, der selten falsch liegt, wird auch beantwortet.
Prinzipien und was ich dafür in Kauf nehme.

Shift left

Checks weisen eine schlechte Änderung im Review ab, bevor sie ausgeliefert wird. Kurz: Fehler früh abfangen.

Was ich dafür in Kauf nehme: Der Aufwand kommt früh, wenn noch nichts kaputt wirkt.

Bewusst langweilig

Das Neue läuft im Schatten mit, bis es passt. Dann wird umgeschaltet, ohne Ausfall.

Was ich dafür in Kauf nehme: Der Parallelbetrieb kostet Wochen.

KI-Agenten mit menschlicher Freigabe

Die mechanische Arbeit machen KI-Agenten. Was sich nicht rückgängig machen lässt, entscheidet ein Mensch. Was ein Agent darf, lege ich so sorgfältig fest wie das, was er kann.

Was ich dafür in Kauf nehme: Jede Freigabe bremst die Arbeit, und zwar mit Absicht.

Die Arbeit steckt in den Nahtstellen

Komponenten sind heute billig, Agenten schreiben sie. Die Entscheidungen, auf die es ankommt, fallen dort, wo Teile aufeinandertreffen: welcher Kontext vorhanden ist, wo der Zustand liegt, wer das Ergebnis verantwortet. Dort verbringe ich meine Zeit.

Was ich dafür in Kauf nehme: Sichtbarer Fortschritt kommt später.

Das Einfachste, das trägt

So wenige Teile wie nötig: weniger Betrieb, weniger Fehlerquellen.

Was ich dafür in Kauf nehme: Ich verzichte auf das elegante Design.

Kalibrierung

Schon im Erstgespräch sage ich, was ich kenne und was ich zum ersten Mal machen würde.

Was ich dafür in Kauf nehme: Manches Mandat geht an jemanden, der mehr versprochen hat.

Diskretion

Dein Name erscheint auf dieser Seite nur, wenn du zustimmst.

Was ich dafür in Kauf nehme: Keine Kundenlogos auf dieser Seite.

Mitten im Team

Ich sitze im Repo, im Standup und im Incident-Channel.

Was ich dafür in Kauf nehme: Das begrenzt, wie viele Mandate gleichzeitig laufen.

Worauf du dich verlassen kannst

Jedes offene Risiko bekommt einen Verantwortlichen und einen Termin.
Was ich baue, betreibt dein Team nach mir selbst.
Läuft etwas nicht, hörst du es zuerst von mir.
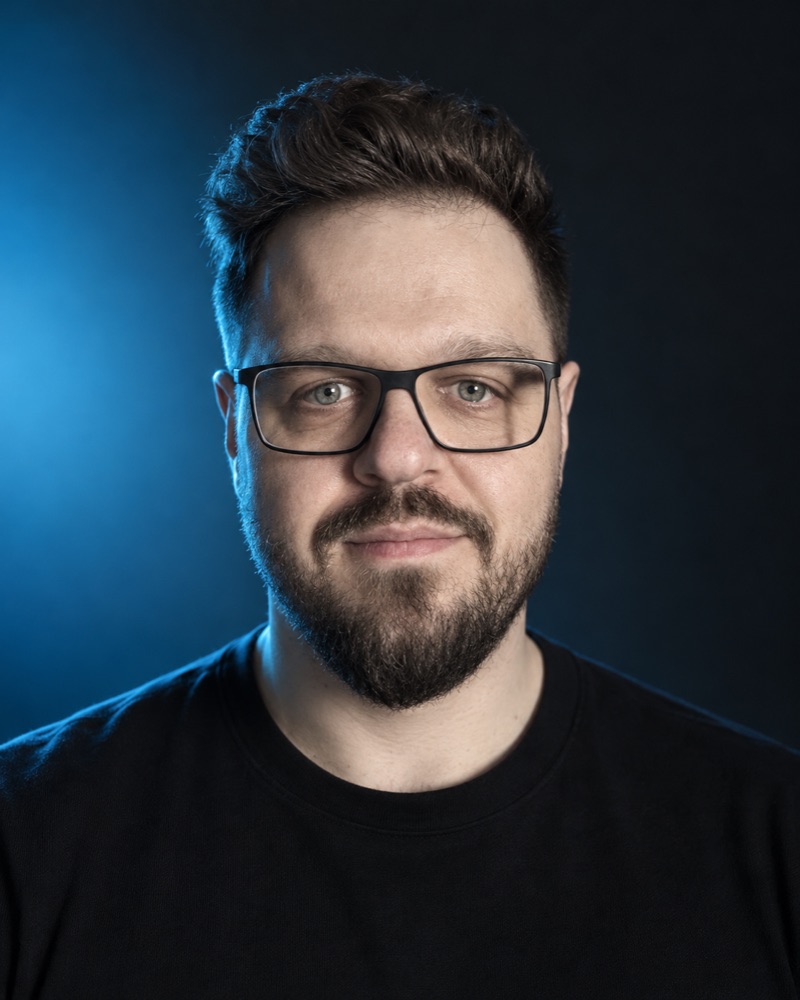
Porträt von Max Köhler

Woher die Spannweite kommt.

Die Arbeit, die ich will
Das Problem, das du schon zweimal eskaliert hast.
SMAHO
Mitgründer und CTO seit 2019; strategische Entscheidungen treffe ich gemeinsam mit meinem Mitgründer. Technik und Produkt, vom ersten Commit bis in Produktion, Hardware eingeschlossen.
Die Spannweite
Wie man das nennt, ändert sich ständig. Die Arbeit bleibt dieselbe: Ich wechsle zwischen den Disziplinen und entscheide dort, wo die Teile zusammenkommen.
Mandate
Seit 2019 freiberuflich, nie in Konkurrenz zu SMAHO oder einem laufenden Mandat.

Beschreib mir die Lage.

Eine kurze Mail reicht: Was steckt fest, bis wann, wer entscheidet?

SMAHO ist meine Hauptaufgabe, deshalb nehme ich nur wenige Mandate an, davon höchstens eines mit zwei bis drei Tagen pro Woche. Meist starte ich innerhalb weniger Wochen, sobald Verträge, NDAs und Onboarding erledigt sind. Sind die Zugänge eingerichtet, geht es gegen Aufpreis auch innerhalb von drei Tagen.